

¿Cómo aprende un robot a mantenerse de pie sin que nadie le escriba la ecuación del péndulo invertido? Igual que aprendiste tú a andar en bicicleta: probando, cayéndose y quedándose con lo que funcionó. Esa es la idea del aprendizaje por refuerzo (RL, por reinforcement learning), la misma técnica que hoy usan Boston Dynamics, Disney Research y los laboratorios que entrenan modelos de lenguaje.
En esta guía vas a entrenar un robot balancín de dos ruedas con el algoritmo PPO (proximal policy optimization) dentro de un simulador de física, sin instalar nada en tu computador, y vas a entender qué pasa adentro de cada pieza: el agente, el entorno, la recompensa, el actor y el crítico. Al final sabrás armar tu propia función de recompensa, leer las curvas de entrenamiento y qué cuidar para que lo aprendido en simulación sirva en un robot real, sea el kit M5Stack Bala2-Fire del autor original o un balancín propio con ESP32 y MPU6050.
Concepto: por qué RL y no un PID
Un robot balancín es el ejemplo clásico de control: es un péndulo invertido sobre ruedas y se resuelve hace décadas con un lazo PID, un regulador LQR o control predictivo (MPC). Entonces, ¿para qué meterle inteligencia artificial?
Justamente porque el problema ya está resuelto, sirve como banco de pruebas. Sabes cómo se ve un balancín que funciona, así que puedes juzgar si el agente aprendió bien. Y lo que aprendes acá escala a robots donde escribir el modelo matemático es casi imposible: un cuadrúpedo, un brazo que agarra objetos de forma irregular o el bípedo Microduck de Pollen Robotics y Hugging Face.
La diferencia de enfoque es esta:
- Control clásico: tú modelas la física (masa, inercia, radio de rueda) y diseñas una ley de control que, con esos números, estabiliza el sistema. Si el modelo está mal, el controlador sufre.
- Aprendizaje por refuerzo: no le das la ley de control. Le das un objetivo medible (la recompensa) y lo dejas probar millones de veces. El resultado suele ser sorprendentemente robusto a cosas que no modelaste, como ruido del sensor o juego mecánico de los motores.
El costo es que entrenar es delicado: la configuración, la recompensa y el paso de simulación a robot real tienen trampas. De eso trata buena parte de este tutorial.
Un poco de historia (en corto)
El RL viene de los años 50: la programación dinámica de Richard Bellman, el trabajo de Marvin Minsky sobre aprendizaje por ensayo y error, y el programa de damas de Arthur Samuel. Todo inspirado en la psicología animal (la ley del efecto de Thorndike y el condicionamiento operante de Skinner).
El salto vino al combinarlo con redes neuronales. En 1992 TD Gammon aprendió backgammon jugando contra sí mismo. En 2013 DQN de DeepMind aprendió decenas de juegos de Atari mirando solo los píxeles, en 2016 AlphaGo le ganó a Lee Sedol y en 2019 OpenAI Five derrotó al equipo profesional OG en Dota 2. Desde entonces el RL profundo salió de los juegos: se usa para afinar modelos de lenguaje y, en 2024, Boston Dynamics lo integró al control de locomoción de Spot junto al MPC que ya usaba.
Las piezas del ciclo de entrenamiento
Todo el RL se reduce a un ciclo que se repite miles de veces por segundo en la simulación:
- El entorno entrega una observación: lo que dicen los sensores en ese instante.
- El agente mira la observación y elige una acción: cuánto mover cada motor.
- El entorno reacciona (el robot se inclina, avanza o retrocede) y devuelve una recompensa, un número que dice qué tan bien salió.
- El algoritmo de aprendizaje usa esa recompensa para ajustar la política, la regla con la que el agente decide.
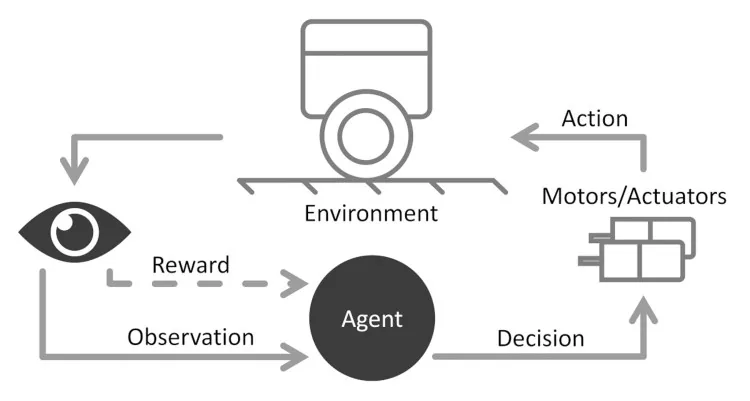
Un detalle que confunde al principio: el "agente" es solo la parte que decide y aprende (la política, el estimador de valor si lo hay y el algoritmo que los actualiza). Todo lo demás es "entorno": el código que lee sensores y calcula la recompensa, los motores, la electrónica, el chasis y el mundo físico. En este balancín la observación viene de una IMU (acelerómetro y giroscopio) y de los dos encoders de los motores.
Diseñar la recompensa: donde está el verdadero trabajo
La recompensa es un solo número por paso de tiempo, pero se arma combinando varios términos:
- Vivo: un premio constante por cada paso en que el robot no se ha caído.
- Inclinación (pitch): un castigo proporcional a cuánto se aleja de la vertical.
- Acción: un castigo por cambios bruscos en el comando a los motores, que lo empuja a hacer correcciones pequeñas.
- Posición: un castigo por alejarse del punto de partida.
- Giro (yaw rate): un castigo por rotar sobre su eje vertical, porque queremos que se quede quieto en su lugar.
Si te preguntas por qué tanto término: el agente es literal. Si solo premias "no caerse", aprende a no caerse arrancando a toda velocidad hacia una pared, porque nada le dijo que eso estaba mal. A esto se le llama reward hacking y es el error más común de quien empieza. Cada término de castigo cierra una trampa que el agente encontraría.
Otro detalle técnico que el original no menciona: fíjate en que la inclinación se castiga al cuadrado (pitch**2) y no en valor absoluto. Con el cuadrado, desviarse 2 grados cuesta cuatro veces lo que cuesta 1 grado, así que el agente tolera oscilaciones chicas pero huye de las grandes. Para el giro se usa el valor absoluto (abs(yaw_rate)), que castiga parejo cualquier rotación, incluso las pequeñas.
Simulación primero, robot después
El entrenamiento corre en un simulador. Eso permite reiniciar el robot cuando se cae (sin romper nada), correr la física más rápido que el tiempo real y lanzar varios entornos en paralelo.
Cuando el agente queda bueno, al robot real solo viaja la política (el "actor"). El estimador de valor (el "crítico") y la recompensa solo sirven para entrenar.
Para que lo aprendido funcione afuera, la observación tiene que significar lo mismo en los dos mundos. Si en la simulación la aceleración va en m/s² y tu sensor real la entrega en g, conviertes antes de dársela al agente. Cualquier filtro, normalización o cambio de unidades que hiciste en la simulación se repite tal cual en el robot.
Con la acción pasa lo mismo al revés. La política entrega un valor normalizado entre -1 y 1 por motor. En el robot lo escalas a PWM: si la salida es -0,73 para el motor izquierdo y tu PWM máximo es 255, pones el driver en reversa y mandas un PWM de 186. Conviene recortar la salida al rango [-1, 1] antes de escalar, porque la red a veces se sale un poco. La regla de oro: un 1,0 tiene que significar lo mismo para el motor real que para el simulado.
PPO: el actor y el crítico
Hay decenas de algoritmos de RL. Aquí se usa PPO, publicado por investigadores de OpenAI en 2017 y que sigue siendo de los más populares tanto para controlar robots como para afinar modelos de lenguaje. El código base es una versión modificada de ppo_continuous_action.py del proyecto CleanRL de Costa Huang, una colección de implementaciones de referencia en un solo archivo cada una, ideales para leer.
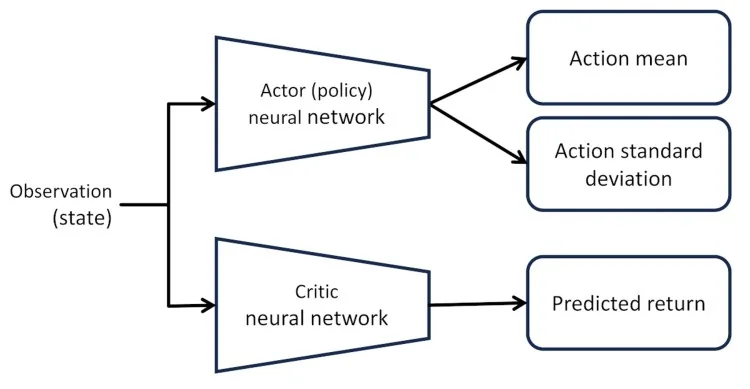
PPO es un método actor crítico: el agente tiene dos redes neuronales separadas.
El crítico: "¿qué tan buena es esta situación?"
El crítico recibe la observación y estima cuánta recompensa total se puede esperar desde ese estado. No intenta modelar la física (con ruido de sensor y motores imperfectos eso sería imposible), sino algo más simple: un número de "qué tan bien voy".
Para entrenarlo, el robot interactúa con el entorno un rato y se guarda un registro de observaciones, acciones y recompensas: eso se llama rollout. La suma de recompensas futuras se llama retorno, y las recompensas más lejanas se descuentan con un factor gamma (por ejemplo 0,99), para que el agente prefiera lo bueno pronto y para que el retorno no crezca sin límite.
Un número que ayuda a elegir gamma: el "horizonte" efectivo que mira el agente es aproximadamente 1 / (1 - gamma) pasos. Con gamma 0,99 son unos 100 pasos, y con pasos de 5 ms eso es medio segundo hacia el futuro, más que suficiente para atajar una caída. Si subieras gamma a 0,999 el agente miraría 5 segundos adelante, el aprendizaje se vuelve más lento y ruidoso, y para balancear no hace falta.
El actor: la política que mueve los motores
El actor recibe la misma observación y entrega la acción. Como aquí la acción es continua (cuánto girar cada motor), el actor no entrega un número fijo sino una distribución normal por motor: una media y una desviación estándar. En CleanRL la red calcula la media y la desviación estándar es un parámetro aparte, uno por motor, que el algoritmo ajusta con el tiempo.
Esa distribución resuelve el dilema de exploración contra explotación. Al principio la desviación es grande: el actor "no sabe" y prueba acciones casi al azar. A medida que aprende, la media se mueve hacia las acciones que dan buen retorno y la desviación se achica: pasa de explorar a usar lo que ya sabe que funciona.
Cómo se entrenan juntos: la ventaja
Después de cada acción se pregunta: ¿salió mejor o peor de lo que el crítico esperaba? Esa diferencia es la ventaja. Si fue positiva, el actor hace esa acción más probable en situaciones parecidas; si fue negativa, menos probable. El crítico estima, el actor decide y los dos se corrigen mutuamente.
El punto débil de los actor crítico es que son quisquillosos con los hiperparámetros (la tasa de aprendizaje, gamma, el tamaño de las redes): los que eliges a mano, a diferencia de los pesos que se ajustan solos.
El aporte de PPO: un límite de velocidad al aprendizaje
PPO reutiliza cada rollout para varias rondas de actualización. El problema es que esos datos se recogieron con la política vieja; si la política cambia demasiado, los datos dejan de representarla y una sola actualización mala puede borrar horas de progreso. PPO lo evita con el recorte (clipping): limita cuánto puede cambiar la probabilidad de cada acción en un paso, típicamente a ±20 % (el parámetro clip_coef = 0,2 en CleanRL). Aprende de a poco y seguro, no a saltos.
Hardware: el robot del original y la ruta con piezas sueltas
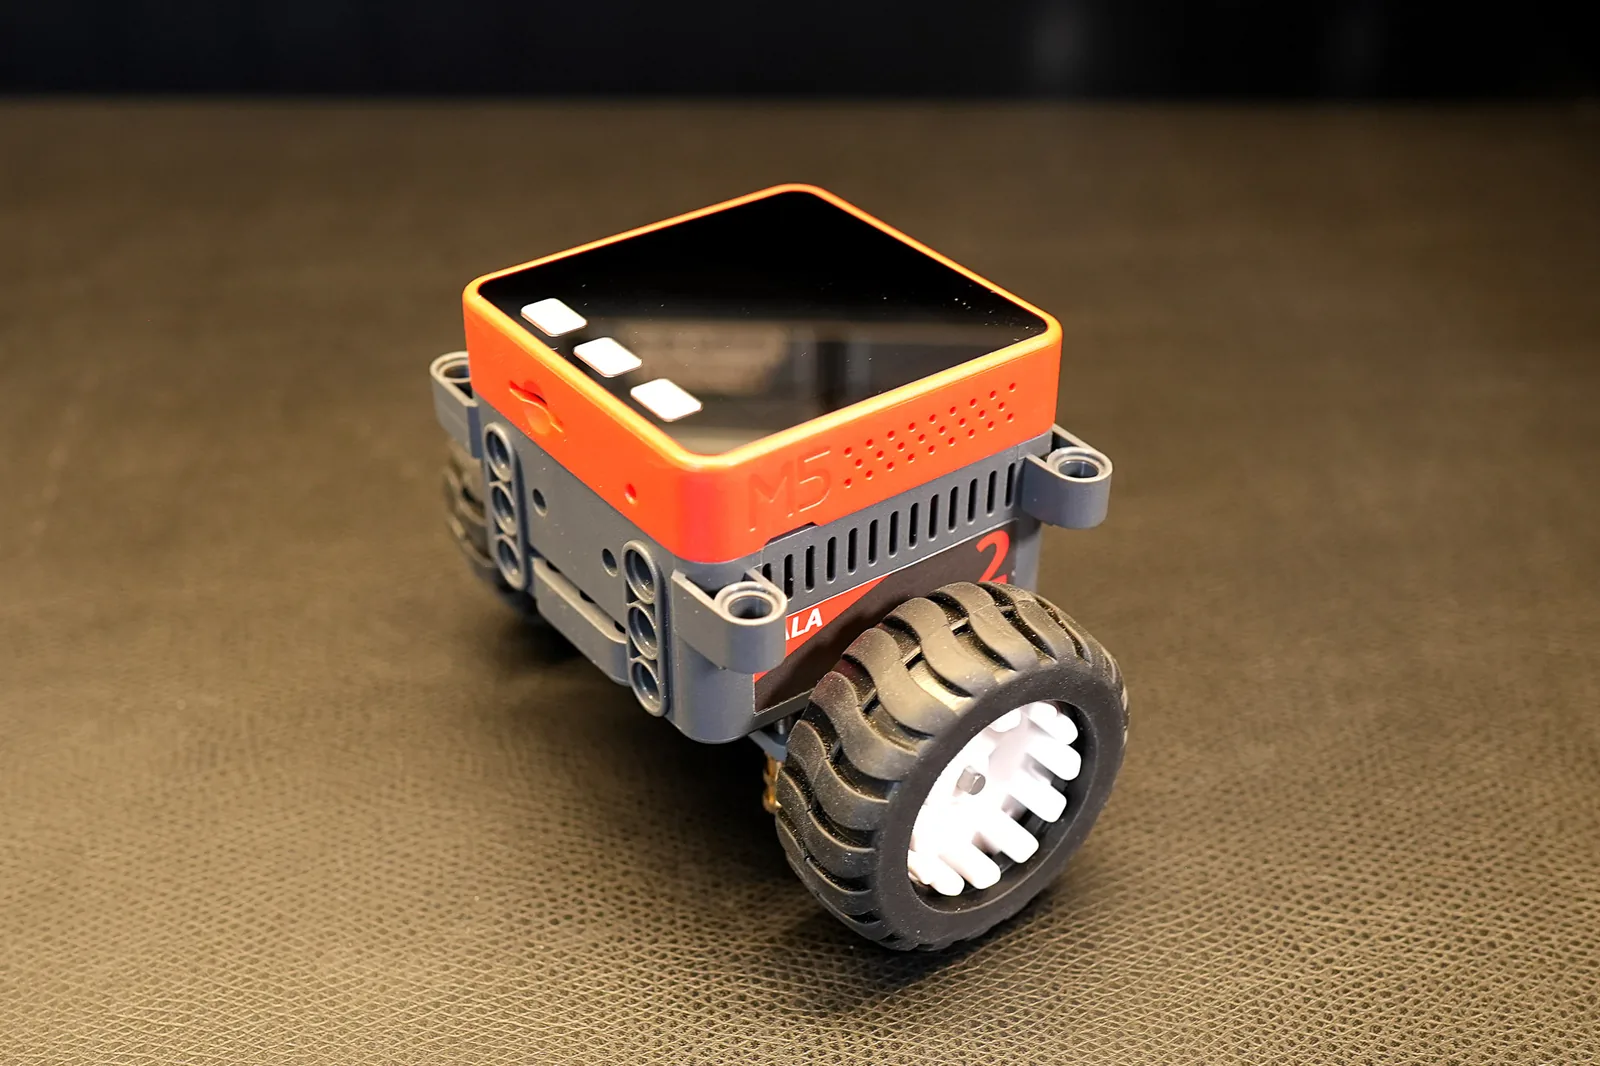
El autor usa el M5Stack Bala2-Fire, un kit de balancín ya armado con un controlador ESP32, IMU, dos motores con encoder y su batería. La ventaja es enorme: el repositorio trae el modelo 3D y la descripción física de exactamente ese robot, así que la simulación se parece mucho al hardware.
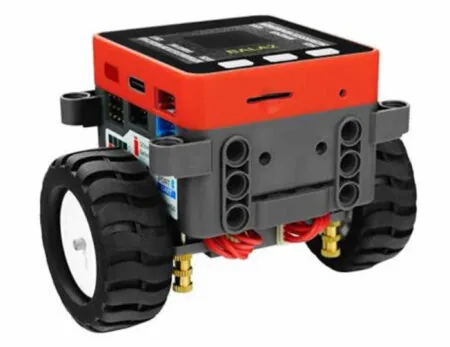
Para el entrenamiento no necesitas ningún robot: todo pasa en el navegador. El hardware solo entra si quieres llevar la política al mundo real.
Si prefieres armar tu propio balancín, el esquema equivalente es:
- Un ESP32 como cerebro (corre la red del actor, que es chica: 2 capas ocultas de 32 neuronas).
- Un MPU6050 como IMU por I2C (pines 21 SDA y 22 SCL en el ESP32 DevKit).
- Un driver TB6612FNG para los dos motores: es más eficiente que un L298N (MOSFET en vez de transistores bipolares, mucho menos voltaje perdido), algo que en un balancín se nota porque cada décima de volt es torque.
- Dos motorreductores con encoder: los encoders son parte de la observación, así que no son opcionales.
- Dos baterías 18650 en serie (unos 7,4 V) en su soporte.
Ojo con algo importante que diferencia esta ruta: la política entrenada para el Bala2-Fire no sirve tal cual en otro robot. Tu balancín tiene otra masa, otra altura del centro de gravedad y otro radio de rueda. Tienes que editar el archivo MJCF del repositorio (masas, momentos de inercia, posición de la IMU, radio de las ruedas) para que describa tu robot y reentrenar. La buena noticia es que con los cuadernos ya armados eso es cambiar números y volver a correr.
Software: preparar el entorno en Google Colab
El entrenamiento corre en Google Colab, un entorno gratuito de Python en el navegador que funciona como un cuaderno Jupyter: el código está dividido en celdas que se ejecutan de a una. El simulador de física es MuJoCo.
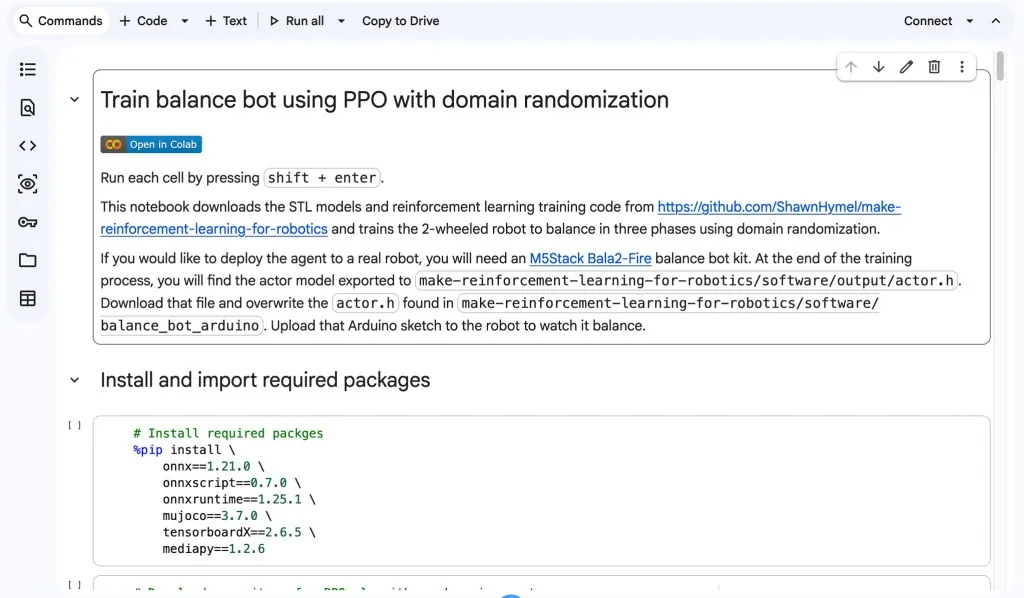
- Abre el cuaderno del autor en Colab:
colab.research.google.com/github/shawnhymel/make-reinforcement-learning-for-robotics/blob/main/software/make_rl_train_balance_bot.ipynb. - Haz clic en la primera celda (empieza con
# Install required packages) y presiona Shift+Enter: ejecuta la celda y salta a la siguiente. - Sigue con Shift+Enter. Las primeras celdas instalan e importan las librerías, algunas hechas a medida en el repositorio del autor.
Lo que vale la pena mirar del repositorio:
mechanical/bala2-fire/meshes: los STL del robot (chasis y dos ruedas).mechanical/bala2-fire/bala2-fire-simplified.xml: el archivo MJCF que le dice a MuJoCo el paso de tiempo (5 ms), cómo cargar y ubicar las mallas, cómo se unen, qué actuadores usar, las masas e inercias, y qué sensores hay y dónde.software/balance_bot_env.py: un entorno de Gymnasium a medida que carga el simulador, arma la observación y aplica las acciones del agente.software/rl/ppo_trainer.py: el PPO de CleanRL modificado, sin las integraciones con Weights & Biases ni Hugging Face y con comentarios que explican cada parte.
La configuración del entrenamiento
Las celdas siguientes fijan los ajustes:
- 8 entornos en paralelo, cada uno con 500.000 pasos en total. No verás el entrenamiento en vivo, porque Colab no tiene visor para MuJoCo.
- Actor y crítico como redes separadas, cada una con 2 capas ocultas de 32 neuronas.
- El paso de tiempo de espera en 0, para que la simulación corra lo más rápido posible en vez de esperar los 5 ms reales.
Después vienen funciones de ayuda para crear los entornos, grabar videos del robot y cargar un agente de una etapa anterior.
Dos pruebas antes de entrenar
Antes de entrenar, el cuaderno hace dos pruebas que conviene no saltarse:
- Sin política: el robot no hace nada y se cae. Confirma que la física y la gravedad están bien.
- Política aleatoria: cada motor recibe una acción al azar en cada paso. El robot probablemente se arrastra o gira hacia un lado y cae de inmediato.
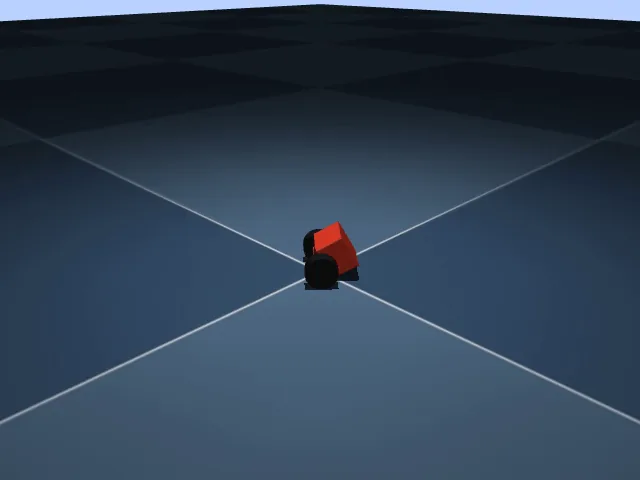
Puedes ver los videos en las mismas celdas o bajarlos desde make-reinforcement-learning-for-robotics/software/output en Colab. Si todo corrió sin errores, estás listo para entrenar.
La política aleatoria es además tu línea base: anota cuántos pasos dura antes de caer. Cualquier agente entrenado tiene que superarla por lejos; si no, algo está mal en la recompensa o en la observación.
Entrenamiento por fases
El robot no aprende todo de una vez. Se entrena en una serie de fases, cada una más difícil que la anterior. Es una idea que en la literatura se llama curriculum learning: primero dominar lo básico y después sumar exigencias, igual que no le pides a alguien que aprenda a andar en bicicleta con viento en contra.
Fase 1: solo equilibrio
En la sección Phase 1: Balance only del cuaderno se fijan los coeficientes de la recompensa (el premio por estar vivo, alive_bonus, queda en su valor por defecto de 1,0):
envs = make_envs(
    NUM_ENVS,
    pitch_penalty_coef=0.5,
    action_penalty_coef=0.01,
    position_penalty_coef=0.001,
    speed_penalty_coef=20.0,
    yaw_penalty_coef=0.1,
)
Y en balance_bot_env.py está cómo se convierten en castigos:
# Compute the penalties
pitch_penalty = self.pitch_penalty_coef * pitch**2
action_penalty = self.action_penalty_coef * np.sum(action**2)
position_penalty = self.position_penalty_coef * (x_pos**2 + y_pos**2)
speed_penalty = self.speed_penalty_coef * (x_vel**2 + y_vel**2)
yaw_penalty = self.yaw_penalty_coef * abs(yaw_rate)
La recompensa final es el premio por estar vivo menos la suma de todos los castigos.
Lee los coeficientes con atención, porque cuentan la intención del diseño. La velocidad tiene un coeficiente enorme (20) porque, en un balancín, moverse es la forma "barata" de no caerse y queremos que se quede quieto. La posición tiene uno minúsculo (0,001): basta para que no se vaya a la deriva, pero no tanto como para que el agente prefiera caerse antes que alejarse un poco. Una prueba útil es calcular a mano cada término para un caso típico (por ejemplo 3 grados de inclinación, que son 0,05 rad) y comparar con el premio de 1,0: si un castigo se come todo el premio, el agente aprende que da lo mismo caerse.
Leer las curvas con TensorBoard
Cuando termina la fase 1, sube a la celda de TensorBoard, la herramienta de visualización que registra y grafica valores durante el entrenamiento.
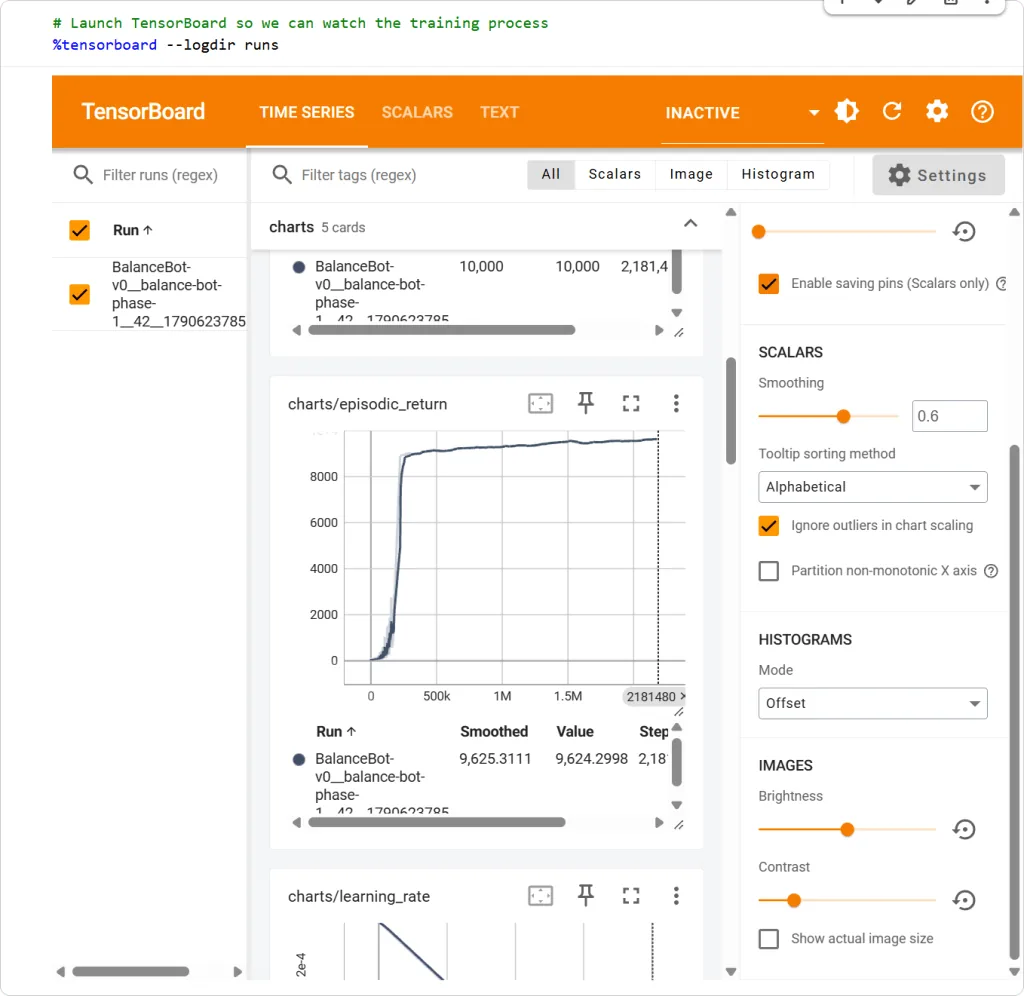
Qué mirar, en orden:
- Retorno por episodio: tiene que subir y estabilizarse. Si sube y después se desploma, la política se rompió en alguna actualización (prueba con una tasa de aprendizaje menor).
- Largo del episodio: cuántos pasos dura el robot antes de caer. Cuando toca el máximo y se queda ahí, ya no se cae.
- Entropía de la política: tiene que bajar de a poco. Si cae a cero muy rápido, el agente dejó de explorar demasiado pronto y quizás se quedó con una solución mediocre.
- Pérdida del crítico (value loss): alta al comienzo, después baja. Si se mantiene alta, el crítico no logra predecir y el actor está aprendiendo a ciegas.
Fase 2 y la aleatorización del dominio
Las fases siguientes cargan el agente de la fase anterior y le suben la exigencia. La herramienta clave es la aleatorización del dominio (DR, domain randomization): en cada episodio se varían un poco los parámetros físicos de la simulación, como masas, fricción o respuesta de los motores.
¿Por qué funciona? Porque tu robot real nunca va a calzar exacto con el modelo. Si el agente solo vio un robot "perfecto", aprende a explotar detalles de ese robot que en la realidad no existen. Si en cambio entrenó con cientos de robots levemente distintos, aprende una política que funciona en todos ellos, y con suerte tu robot real cae dentro de ese rango. Es la técnica más usada para cruzar la brecha entre simulación y realidad (sim to real gap).
Al terminar, mira el video de evaluación de la fase 2: el robot debería seguir balanceándose en su lugar.
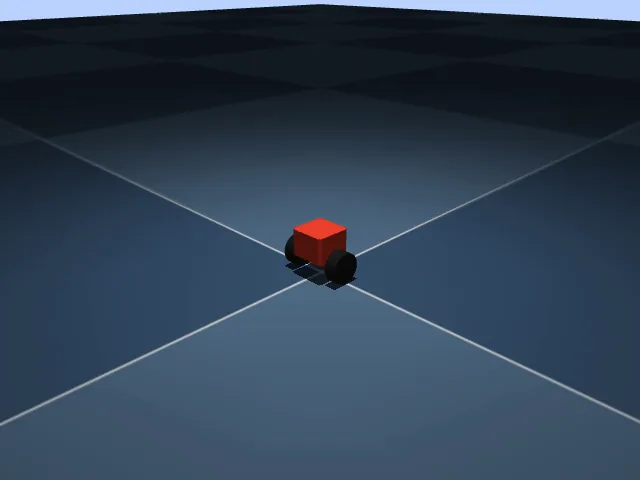
Después de esto, experimenta: cambia los coeficientes de la recompensa o los rangos de aleatorización y mira cómo responde el agente con entrenamiento adicional. Es la mejor forma de desarrollar intuición.
Pruebas y errores comunes
- El robot aprende a avanzar en vez de quedarse quieto: el castigo por velocidad o por posición es demasiado bajo comparado con el de inclinación. Súbelo de a poco.
- El robot tiembla mucho en la simulación: sube
action_penalty_coef. Ese temblor en el robot real se traduce en motores calientes y engranajes gastados. - Funciona en simulación pero se cae en el robot real: casi siempre es una observación que no significa lo mismo (unidades, signo de un eje de la IMU, encoders contando al revés). Imprime por serial la observación del robot real quieto y compárala con la de la simulación quieta antes de culpar a la red.
- El robot real reacciona tarde: la simulación supone que el ciclo dura 5 ms. Si tu lazo en el ESP32 lee la IMU, ejecuta la red y escribe el PWM en 15 ms, la política está corriendo en un mundo más lento que el que conoció. Mide el tiempo del lazo con
micros()y mantenlo fijo. - La red no cabe o es lenta en el microcontrolador: una red de 2×32 son unos pocos miles de multiplicaciones por paso, nada para un ESP32. Exporta los pesos del actor (solo el actor) como arreglos de C y haz la multiplicación de matrices a mano; no necesitas TensorFlow Lite para algo de este tamaño.
Variantes y mejoras
- Control remoto: agrega a la observación una velocidad deseada (avanzar, retroceder, girar) y cambia el castigo de posición por uno que mida la diferencia con esa consigna. Así el mismo agente aprende a balancearse y a obedecer; desde el ESP32 puedes recibir la consigna por Bluetooth desde el celular. El autor muestra este paso en su serie de videos en el canal de YouTube de DigiKey.
- Compara con un PID: programa un PID clásico en el mismo robot y mide ambos con la misma perturbación (un empujón con el dedo, o subir el robot a una alfombra). Es la mejor forma de ver dónde el RL gana en robustez y dónde el PID gana en simplicidad.
- Pasa a un cuadrúpedo: con el mismo cuaderno como plantilla, cambia el MJCF por el de un robot con servos (por ejemplo un perrito de 8 servos SG90 manejados por un PCA9685) y una recompensa que premie avanzar sin caerse. Es exactamente el camino que siguen los laboratorios grandes.
Personalización para Chile
En Chile consigues lo necesario para la ruta con piezas sueltas en MechatronicStore:
- ESP32 con Wifi y Bluetooth ESP WROOM-32 Tipo C (SKU X2-10V2): corre la red del actor y el lazo de control; reemplaza al controlador del Bala2-Fire.
- Giroscopio y Acelerómetro IMU MPU6050 GY 521 (SKU GO3-4): la IMU que mide inclinación y velocidad angular por I2C.
- Controlador/Driver Motor TB6612FNG (SKU GU2-9): maneja los dos motores en ambos sentidos con PWM.
- Batería 18650 recargable 3.7V (SKU GT2-10): dos en serie alimentan motores y electrónica.
- Soporte porta batería doble 18650 (SKU C-109): sostiene las dos celdas en serie.
El kit M5Stack Bala2-Fire del tutorial original no está en el catálogo, y los motorreductores con encoder adecuados para un balancín chico tampoco están hoy en stock. La ruta con piezas sueltas cumple la misma función, pero acuérdate de que exige ajustar el modelo MJCF a tu robot y reentrenar. Para la parte de simulación no necesitas comprar nada.
Recursos
- Tutorial original (inglés): Train a Balance Bot With Reinforcement Learning, de Shawn Hymel en Make: Vol. 99. Esta guía está basada en él.
- Repositorio GitHub: make reinforcement learning for robotics, con el cuaderno de Colab, el modelo MJCF y los STL del robot.
- Implementación de referencia de PPO: CleanRL, archivo
ppo_continuous_action.py. - Documentación adicional: MuJoCo y Gymnasium.
Versión chilena con componentes en stock local en MechatronicStore.